
Kenapa AI Secanggih Apapun Masih Suka Berhalusinasi
Halusinasi AI terjadi karena model memprediksi kata berdasarkan pola statistik, bukan mengambil fakta, dan dilatih untuk terdengar yakin meski sebenarnya tidak tahu.
Sebuah model AI ditanya siapa penulis buku tertentu, dan ia menjawab dengan nama yang terdengar meyakinkan, lengkap dengan tahun terbit dan penerbit. Masalahnya, buku itu tidak pernah ada. Penulis, tahun, penerbit, semuanya karangan model, tapi disampaikan dengan nada yang sama percaya dirinya seperti ketika ia benar. Fenomena ini disebut halusinasi, dan ia tidak hilang meski model yang dipakai adalah yang paling mutakhir sekalipun. Pertanyaannya bukan apakah ini akan terjadi, tapi kenapa hal ini sulit dihindari secara struktural.
Model Bahasa Memprediksi Kata, Bukan Mengambil Fakta
Inti dari model bahasa besar adalah sistem yang memprediksi kata berikutnya berdasarkan pola dari miliaran teks yang pernah dilihatnya. Ketika ditanya sesuatu, model tidak membuka semacam kartu indeks berisi fakta lalu mengutipnya. Ia menyusun jawaban kata demi kata berdasarkan probabilitas kata mana yang paling masuk akal muncul selanjutnya, mengingat konteks pertanyaan dan seluruh kata yang sudah ia tulis sebelumnya.
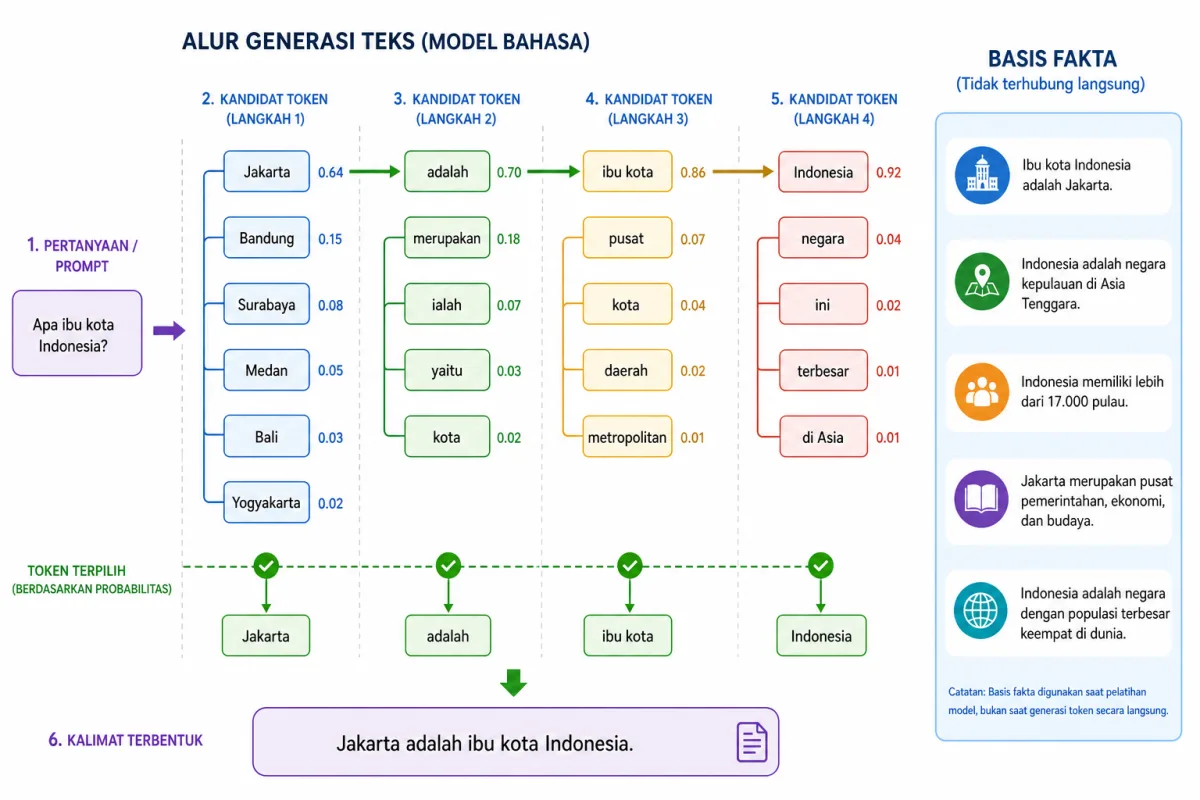
Ini penting untuk dipahami karena mekanismenya menjelaskan kenapa halusinasi bisa terjadi tanpa model "berbohong" dalam arti sadar. Ketika model tidak punya informasi pasti tentang sesuatu, ia tetap harus memilih kata berikutnya karena itulah cara kerjanya, ia tidak punya opsi untuk berhenti dan bilang "saya tidak tahu" secara default. Yang terjadi adalah model mengisi kekosongan itu dengan pola yang paling mirip dengan jawaban benar yang pernah ia lihat, meski isinya salah.
Bayangkan seseorang yang diminta menceritakan detail sebuah film yang judulnya mirip dengan film lain yang benar-benar ia tonton. Karena otaknya terbiasa dengan pola cerita semacam itu, ia bisa saja menceritakan alur yang masuk akal tapi sebenarnya mencampur dua film berbeda. Model AI melakukan hal serupa dalam skala jauh lebih besar dan dengan kecepatan yang membuat kesalahan itu tidak terasa seperti tebakan.
Batasannya: untuk pertanyaan yang jawabannya sangat sering muncul dalam data pelatihan seperti ibu kota negara besar atau rumus matematika dasar, pola yang terbentuk begitu kuat sehingga hampir tidak pernah salah. Halusinasi lebih sering muncul pada hal spesifik, jarang dibahas, atau berada di batas pengetahuan model.
Model Dilatih untuk Terdengar Meyakinkan, Bukan untuk Mengakui Ketidaktahuan
Proses pelatihan lanjutan yang membuat model AI terasa lancar bicara, sopan, dan percaya diri biasa disebut fine-tuning atau penyesuaian dengan umpan balik manusia punya efek samping yang jarang disadari orang. Manusia yang memberi penilaian selama proses ini cenderung lebih menyukai jawaban yang tegas dan lengkap dibanding jawaban yang penuh keraguan atau pengakuan "saya tidak yakin".
Akibatnya, model belajar bahwa jawaban yang terdengar pasti mendapat nilai lebih baik daripada jawaban yang jujur soal ketidakpastian. Ini bukan soal model punya niat menipu, tapi soal insentif yang dibentuk selama pelatihan lebih mengarah ke "terdengar kompeten" dibanding "akurat tapi ragu-ragu". Dalam banyak kasus, nada percaya diri yang sama dipakai baik ketika model benar maupun ketika ia mengarang.
Contohnya bisa dilihat ketika model diminta membuat kutipan dari sebuah penelitian. Alih-alih menjawab bahwa ia tidak memiliki akses ke sumber spesifik itu, model kerap menyusun kutipan yang formatnya benar, ada nama penulis, tahun, judul jurnal tapi isinya fiktif. Formatnya meyakinkan karena model tahu persis bagaimana rupa kutipan ilmiah yang baik, meski isinya tidak pernah benar-benar ada.
Batasannya: sejumlah model generasi terbaru sudah mulai dilatih secara khusus untuk lebih sering mengakui ketidaktahuan, terutama untuk pertanyaan berisiko tinggi seperti soal medis atau hukum. Tapi kemampuan ini tidak merata di semua topik, dan masih bergantung pada seberapa jelas pertanyaan menyentuh area yang memang dilatih untuk kehati-hatian tersebut.
Pengetahuan Model Terkompresi, Bukan Tersimpan Utuh
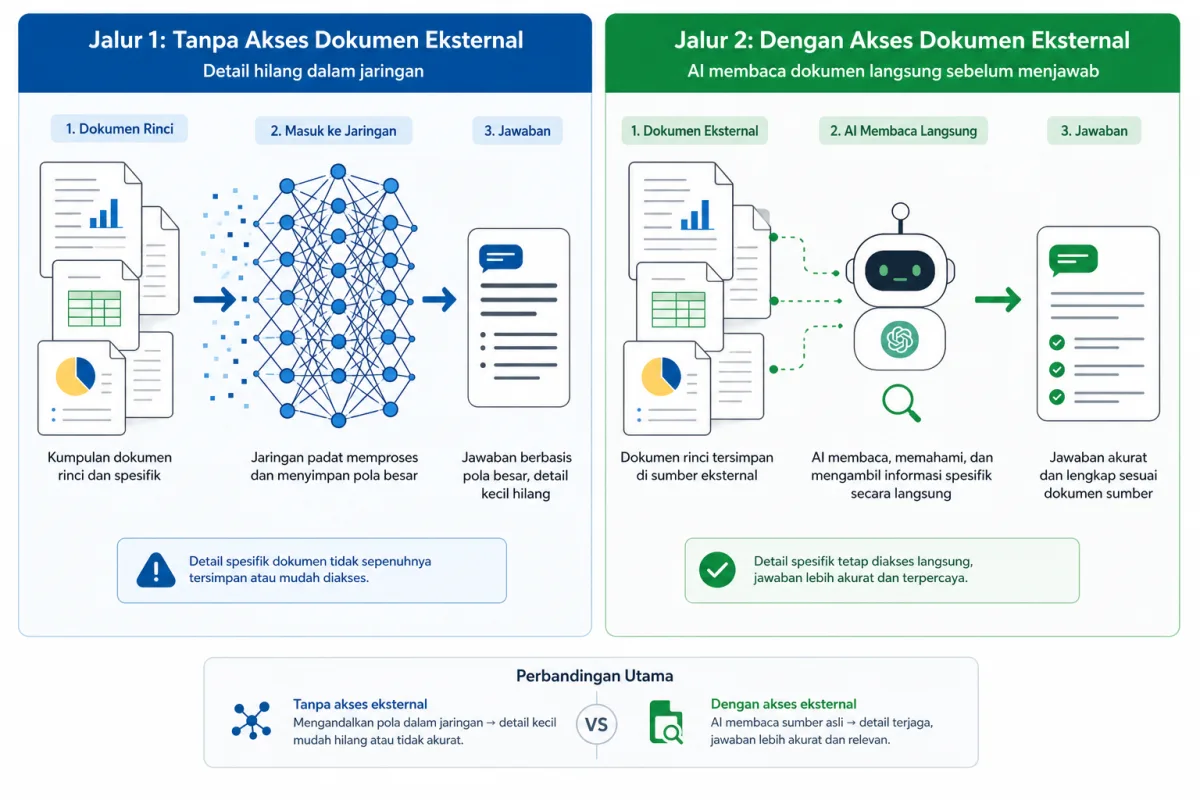
Model bahasa tidak menyimpan setiap dokumen yang pernah dilihatnya secara utuh, melainkan mengubah pola-pola dari data itu menjadi bobot numerik dalam jaringan sarafnya. Proses ini mirip kompresi ekstrem, informasi yang jumlahnya jauh lebih besar dari kapasitas model dipadatkan menjadi representasi pola yang jauh lebih ringkas.
Konsekuensinya, detail-detail kecil dan spesifik sering hilang atau tercampur selama proses kompresi ini, sementara pola besar yang sering berulang tetap bertahan kuat. Ini menjelaskan kenapa model AI biasanya jauh lebih andal ketika ditanya konsep umum dibanding ketika diminta detail yang sangat spesifik seperti nomor pasal tertentu dalam undang-undang atau data statistik dari laporan yang jarang dikutip.
Sebagai gambaran, ketika model diminta menyebutkan nama semua kabupaten yang mengeluarkan kebijakan tertentu, ia bisa jadi menyebutkan kombinasi yang sebagian benar dan sebagian keliru, karena detail granular semacam itu jarang muncul cukup sering dalam data pelatihan untuk membentuk pola yang stabil. Yang tersisa hanyalah pola umum "beberapa daerah mengeluarkan kebijakan semacam ini", lalu model mengisi nama daerah berdasarkan kemiripan pola, bukan ingatan pasti.
Batasannya: masalah ini bisa dikurangi ketika model diberi akses ke sumber eksternal secara langsung, seperti pencarian web atau dokumen yang diunggah pengguna. Dalam kondisi itu, model tidak lagi mengandalkan ingatan terkompresi dari data pelatihan, melainkan membaca ulang teks yang relevan sebelum menjawab, sehingga akurasi biasanya meningkat cukup jauh dibanding jawaban dari ingatan murni.
Tidak Ada Mekanisme Internal untuk Memverifikasi Kebenaran
Manusia biasanya punya rasa curiga bawaan ketika mengatakan sesuatu yang tidak yakin kebenarannya, semacam sinyal internal yang membuat kita ragu sebelum bicara. Model AI generasi saat ini pada dasarnya tidak memiliki mekanisme setara yang bisa mengecek kebenaran jawabannya sendiri sebelum ditulis. Ia menghasilkan teks berdasarkan pola statistik, bukan berdasarkan proses verifikasi terhadap sumber kebenaran eksternal.
Ini yang membuat halusinasi berbeda dari sekadar kesalahan biasa. Kesalahan manusia biasanya diikuti tanda keraguan, nada bicara yang berubah, jeda, atau kalimat "kalau tidak salah". Model AI menghasilkan token dengan cara yang sama baik ketika informasinya benar maupun ketika sepenuhnya mengarang, karena proses pembuatannya tidak melibatkan langkah pengecekan fakta secara terpisah dari langkah menyusun kalimat.
Contoh yang sering muncul adalah ketika model diminta menghitung sesuatu yang melibatkan banyak langkah, seperti soal matematika bertingkat. Di langkah ketiga atau keempat, kesalahan kecil bisa masuk tanpa terdeteksi, dan model terus melanjutkan perhitungan berikutnya seolah semuanya benar, karena tidak ada proses berhenti sejenak untuk mengecek ulang hasil sebelumnya.
Batasannya: sejumlah pendekatan baru mencoba menambal ini dari luar, misalnya dengan meminta model menjelaskan langkah berpikirnya secara eksplisit sebelum memberi jawaban akhir, atau menggabungkan beberapa model untuk saling mengecek. Pendekatan ini terbukti mengurangi tingkat halusinasi pada sejumlah pengujian, tapi belum menghilangkannya sepenuhnya, dan efektivitasnya bervariasi tergantung jenis pertanyaan.
Yang Perlu Dilakukan Pengguna, Bukan Hanya Menunggu Model Membaik
Halusinasi bukan bug yang akan hilang total di update berikutnya, melainkan konsekuensi dari cara kerja dasar model bahasa saat ini. Perbaikan yang terus dilakukan pengembang memang menurunkan frekuensinya dari waktu ke waktu, tapi menghilangkannya sepenuhnya berarti mengubah cara kerja fundamental model, sesuatu yang sampai sekarang belum ada solusinya secara meyakinkan.
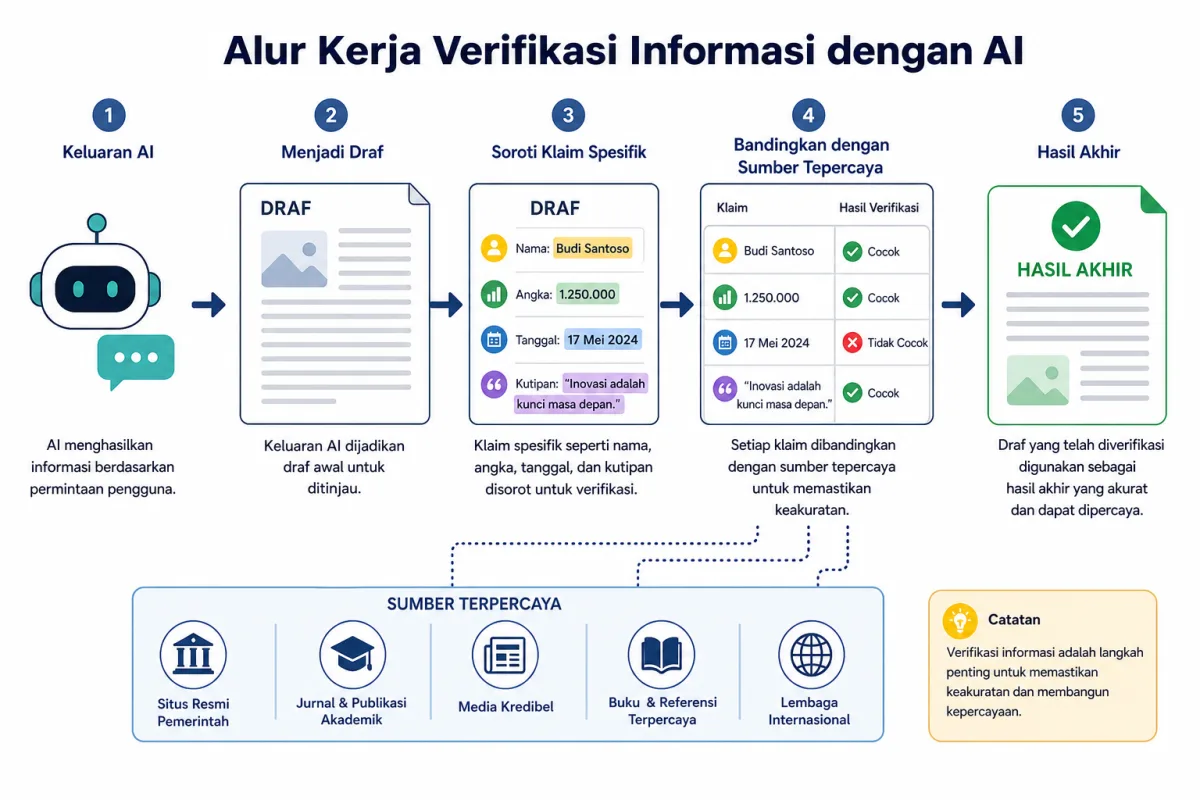
Bagi pengguna, ini berarti kebiasaan yang paling berguna bukan mencari model yang "tidak pernah salah", melainkan membentuk kebiasaan mengecek ulang klaim spesifik — nama, angka, kutipan, tanggal, terutama untuk hal yang berkonsekuensi nyata seperti keputusan medis, hukum, atau finansial. Model AI paling berguna diperlakukan sebagai asisten yang cepat menyusun draf awal, bukan sebagai sumber kebenaran final.
Lely
AdminDIPON STARTER.